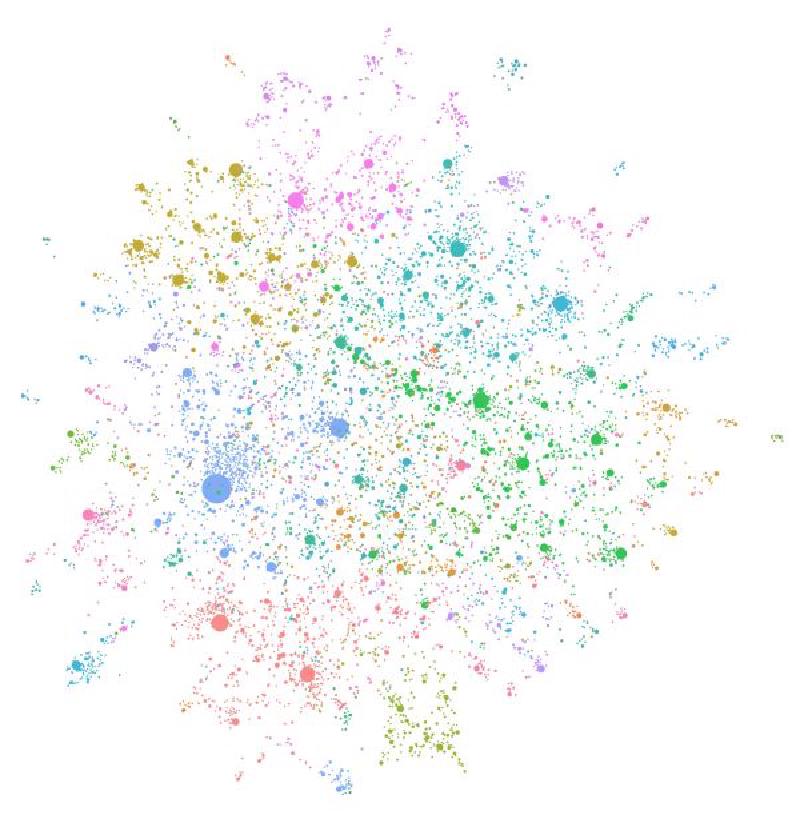
去年 4 月,微软在 Arxiv 上发表了 GraphRAG 的论文,并在 7 月将有关代码在 GitHub 上开源出来,大约在 7 天内就拿到了 6.7k stars。而在今年暑假笔者恰好接触到了一些在实际生产环境中使用 RAG 系统的业务,因此尝试在这里追踪和解读一下基于图的 RAG 方法的学术研究。
NaiveRAG
通常在各种论文里用 NaiveRAG 或者 BaselineRAG 表示最基础的 RAG 方法。RAG (Retrieval-Augmented Generation, 检索增强生成) 是一种设法将与问题相关的特定领域知识放入大模型上下文,从而使其能准确回答该领域问题的技术。其优势在于知识库规模不受大模型上下文长度制约,且无需在知识领域发生变化时重新调整模型本身,具有高度可扩展性。
好吧,这种定义性文字看着很头疼,所以让我们来换个角度。
众所周知,大模型在回答专业领域问题时经常会出现幻觉而产生不准确的答案。
现在,你被安排做一个专门回答法律领域相关问题的聊天机器人。
如果机器人回答出错,你可能会被甲方青蒜。
你想到可以简单地把法律条文一股脑塞进问答的提示词 (Prompts) 里。
但一番尝试后你发现这根本行不通:
法律条文太多,大模型上下文不够用;
就算够用,大模型的指令遵循等能力也会明显下降。
你突然想到了平时使用的联网搜索功能,用联网搜索能解决这个问题吗?
甲方告诉你他们还有一些网上搜不到的内部文档,联网搜索也搞不定了。
那能不能在本地想办法构建一个“法律知识库”呢?
你试着把法律文档全部放到一起组成一个数据库。
然后你开始研究如何让大模型在回答问题前从数据库里搜索知识。
恭喜你,你发明了最简单的检索增强生成方法——NaiveRAG。把过程分解成两步就是下面这样。
这是用文档建立知识库的流程:
这是使用知识库来做回答的流程:
网上有很多传统 RAG 方法的资料,包括怎么做嵌入,怎么做向量搜索,以后笔者可能会再单独写一篇文章聊 NaiveRAG,这里就先不赘述了。
GraphRAG
原论文的 Arxiv 链接。
GraphRAG 是微软开源的一套基于图结构的 RAG 方法。微软官方的说法:
GraphRAG is a structured, hierarchical approach to Retrieval Augmented Generation (RAG), as opposed to naive semantic-search approaches using plain text snippets. The GraphRAG process involves extracting a knowledge graph out of raw text, building a community hierarchy, generating summaries for these communities, and then leveraging these structures when perform RAG-based tasks.
简单来说,它通过从文档中提取出“知识图谱”,并采用算法划分为社群,调用 LLM 为每个社群生成一份总结,在回答问题时分别在这些社群上生成一份答案,最终再使用 LLM 在这些回答的基础上生成最终答案。
为什么要这么做?
在解释为什么要使用 GraphRAG 之前,我们可以先仔细审视传统 RAG 采用的方法,看看它有什么缺陷。
| 方法 | 缺陷 | 改进 |
|---|---|---|
| 对文本进行分块后嵌入 | 知识被切断,导致文本块不能表示完整信息 | 适应文档的分块方法,如分隔符(对法律条文),或引入 LLM |
| 采用向量化方法进行嵌入和匹配 | 对“关键词”的匹配能力非常弱 | 使用“混合检索”策略,即关键词相似度和向量相似度进行加权 |
| 基于相似度分数排序文本块 | 相似度得分无法完全表示和问题的相关程度 | 引入重排序模型 (Reranker),代价是检索速度会明显变慢 |
| 直接用问题文本匹配文本块 | 多轮对话中由于代词等原因,召回率显著降低 | 利用 LLM 等进行查询重写,即构造出更容易检索知识的提问 |
而 GraphRAG 指向了传统 RAG 的一个顽固问题:无法有效利用所有知识块,导致无法回答全局性的问题,例如“这些文档的主题是什么?”,传统 RAG 使用这个提问很难找到有效的知识块,因此也就很难合理地回答这个问题。
为了让大模型回答时能使用所有文本块提高的知识,提高答案的全面性,微软提出了 GraphRAG 的方法。
那它是怎么做的?
GraphRAG 和传统 RAG 一样先采用固定长度分块法切分文本,然后按照下面的流程构建它的数据库:
调用 LLM 为每个文本块提取实体和关系;
例如:“库克在2025年发布了iPhone 17。”
实体:“库克”、“iPhone 17”
关系:“发布”
通过所有的实体和关系构建一个图;
在这个图上运行 Leiden 社区发现算法;
调用 LLM 为每个社区生成一份摘要;
将所有社区摘要存储作为数据库,这是将来用于检索的数据。
执行询问时,其使用一个 Map-Reduce 流程:
先在每个社区摘要上并行地为问题生成一个答案;
LLM 回答问题时会给出一个帮助性分数;
将帮助性分数最高的一些答案合并起来送入 LLM 上下文;
由 LLM 在此基础上生成一个最终的答案。
总之它在构建知识库和回答问题的过程中都反复多次地调用 LLM 来处理数据,在它自己的 Benchmark,也就是“自适应测试集”评测下,微软认为这套方法明显地提高了 RAG 方法的全局感知能力。
有什么问题?
成本
笔者认为这套系统目前最显著的问题就是成本已经高昂到无法接受的地步。参考下面的B站视频:
使用云端 API,完整构建《圣诞颂歌》(约200页)的索引,回答“这个故事的主旨是什么”,总消费 11 美元。
请求了 449 次 GPT-4 的 API,成本相对较低的嵌入模型仅调用了 19 次。
另外,根据笔者的经验,使用诸如轨迹流动这样的 API 平台可能还会严重地受到 Rate Limit 的限制。
使用本地大模型,提取实体构建索引的时间极长。
- 由于本地模型的性能限制,其可能无法输出正确的 JSON 格式结果导致嵌入过程失败。
另外,花费了如此庞大的代价构建索引后,如果还想加入新的文档,必须从头开始所有的嵌入过程。这在生产环境下几乎是不可接受的。
以上的原因直接导致了 GraphRAG 难以投入实际生产使用。
数据集
GraphRAG 的论文认为现有的测试集“不适用于全局感知任务评估”,因此完全没有在传统 RAG 使用的测试集上进行测试,而是自己设计了所谓的“自适应测试集”方法 (原文 Algorithm 1):
生成全局性的问题:
向 LLM 提供对目标数据集的高层次描述及其用途。
要求 LLM 根据语料库的描述,生成 $K$ 个可能会使用该数据集的潜在用户画像。
- 例如,对于播客文稿数据集,一个可能的用户画像是“寻找科技行业见解和趋势的科技记者” 。
针对每一个生成的用户画像,继续要求 LLM 识别出该用户可能会使用这个数据集完成的 $N$ 个相关任务 。
- 例如,对于“科技记者”这个用户,一个可能的任务是“了解科技领袖如何看待政策和监管的作用” 。
最后,针对每一个用户-任务组合,提示 LLM 生成 $M$ 个高层次问题。这些问题满足:
需要对整个语料库有全面的理解才能回答。
不能通过检索特定的、低层次的局部事实来回答。
例如,对于“科技记者”这个用户,一个可能的任务是“了解科技领袖如何看待政策和监管的作用” 。
整理生成的所有问题,最终形成一个包含 $K×N×M$ 个问题的测试集,用于后续评估。
- 在论文的实验中,研究人员设定 $K、N、M$ 均为 5,每个数据集共生成 125 个测试问题。
评估生成的答案:
将测试集中的问题分别输入到 GraphRAG 和传统 RAG 系统中,获取答案。
将同一个问题和两个系统生成的答案同时提供给一个作为裁判的 LLM。即典型的 LLM-as-a-Judge 方法。
提示评估者 LLM 根据预设的评估标准,判断出赢家,或者平局。
记录胜负评估结果以及 LLM 给出的评判理由。为了保证结果的稳定性,每次比较都会重复多次并取平均值。
评估使用的 Prompt 如下:
| |
其中的 {criteria} 部分内容如下,可以明显看出其对“全面性”的偏好性:
- Comprehensiveness. How much detail does the answer provide to cover all aspects and details of the question?
- Diversity. How varied and rich is the answer in providing different perspectives and insights on the question?
- Empowerment. How well does the answer help the reader understand and make informed judgments about the topic?
笔者认为,这一测试方法有明显的先射箭再画靶子的嫌疑。从目标 (提高回答全面性) 到测试集 (针对性的全局性提问) 到评估指标 (LLM裁判指标) 都是 GraphRAG 方法的“优势区间”。说白了就是既当运动员又当裁判。
而且,仅在它的数据集上领先无法证明 GraphRAG 具有泛用性。
一些缓解办法
GraphRAG 目前在 GitHub 上还在进行活跃的更新。针对于上面的成本问题微软又提出了 LazyGraphRAG,不过笔者还没有仔细研究。
LightRAG
来自香港大学的学者参考了 GraphRAG 采用图结构来存储知识库的思路,改良出了另一种基于图的 RAG 方法。其核心目的是解决 GraphRAG 在成本和效率上的短板。它省去了划分社区和生成摘要这两个成本极其高昂的步骤,改为使用一种基于双层关键词的范式。
那它又是怎么做的?
它和 GraphRAG 一样让 LLM 基于提示词提取实体关系,不过 LightRAG 使用的是一个三合一提示词,同时提取实体、关系和关键词。其中的关键词又分为高层关键词和低层关键词。
高层关键词概括文本主题;
低层关键词概括实体关系。
| |
还是和传统 RAG 一样,对文本进行分块,然后它的知识库构建过程是这样的:
还是先提取实体和关系;
调用 LLM 使用上面的三合一 Prompt 为图中的每一个实体节点和每一个关系边都生成一个文本的“键值对”。
其中,“键”是用于高效检索的关键词,而“值”是一段由 LLM 生成的总结性报告 (
和GraphRAG殊途同归了属于是),用于后续的答案生成。对于实体节点来说,关键词是低层的;
对于关系边来说,关键词是高层的。
执行去重,识别和合并来自不同文本块的相同实体和关系 。
- 目的是通过最小化图的规模来减少图操作的相关开销,从而实现更高效的数据处理 。
最终被存入数据库的是知识图谱本身而非 GraphRAG 一样的各部分社区摘要。
执行询问时,LightRAG 不会和 GraphRAG 一样进行很多次生成,而是执行下面的流程:
从用户问题中提取双层关键词;
低层关键词是指代具体实体、细节的词;
高层关键词是表示主题、概念的词。
例如,对于查询“国际贸易如何影响全球经济稳定?”
高层关键词是“国际贸易”、“全球经济稳定”;
低层关键词可能是“贸易协定”、“关税”等。
在数据库中按向量方法检索关键词对应的关系边和实体节点;
对于找到的节点和边,收集被检索到的节点或边的一跳相邻节点;
把这些元素对应的总结性报告组装起来放入模型上下文;
由 LLM 以这部分上下文为依据生成最终答案。
然后也是跑一趟微软的自适应测试集,在他们的论文里声称分数超过了原本的 GraphRAG 方法。
那这么做有什么好处?
笔者目前还没有非常仔细地研究过 LightRAG 的论文,不过根据之前的实践经验来看,它确实比 GraphRAG 的成本更低,但主要并不是体现在嵌入阶段,而是其提问阶段时不必和后者的 Map-Reduce 一样要求进行很多次生成。
另外,笔者推测,由于其保留了向量检索和原始文本块,它在涉及具体细节的问答上表现应该会优于 GraphRAG。